88% de precisión. Cero cajas negras. Eso es lo que nuestro equipo ha traído de Santiago de Compostela, donde se entrenó el modelo central de PREVICTS junto a los investigadores del Instituto de Investigación Sanitaria de Santiago de Compostela (IDIS).
PREVICTS es un pipeline de IA explicable para la detección y prevención del ictus. Predice el tipo de ictus a partir de datos sanguíneos y de comportamiento y, lo que es igual de importante, explica a los clínicos por qué ha llegado a esa predicción, de una forma que pueden leer, cuestionar y en la que pueden confiar.
Por qué el ictus es una carrera contrarreloj
El ictus es una de las principales causas de muerte y de discapacidad a largo plazo en todo el mundo. Se produce cuando se interrumpe el flujo de sangre hacia una parte del cerebro, y cada minuto sin tratamiento puede suponer más tejido cerebral perdido.
No todos los ictus son iguales. En un ictus aterotrombótico, se forma un coágulo en una arteria que irriga el cerebro, mientras que en un ictus cardioembólico el coágulo se forma en el corazón y viaja hasta el cerebro. Aunque sus causas son distintas, ambos tipos requieren atención médica urgente, y los tratamientos que disuelven coágulos pueden ser beneficiosos en unos casos y peligrosos en otros, según la situación del paciente.
Por eso es tan importante conocer el tipo de ictus, y conocerlo pronto. Condiciona el tratamiento que recibe el paciente, el seguimiento que necesita y las medidas que se pueden tomar para prevenir un nuevo episodio.
Los marcadores sanguíneos y los factores de comportamiento, como el estilo de vida y los hábitos, contienen señales valiosas sobre el riesgo del paciente y el tipo de ictus. El reto es convertir esa información en algo sobre lo que un clínico pueda actuar.
Por qué una predicción no basta
Nuestro punto de partida fueron datos sanguíneos y de comportamiento de 4.000 personas que habían sufrido un ictus. Con un conjunto de datos así, lo habitual en IA es recurrir a un modelo profundo de caja negra y perseguir la máxima puntuación posible.
En medicina, eso no es suficiente. Un modelo que dice «este paciente tiene un 70 % de probabilidad de sufrir este tipo de ictus» sin decir por qué deja al neurólogo con un número que no puede verificar, cuestionar ni explicar a un colega o a un paciente. Los clínicos son responsables de sus decisiones, así que necesitan ver el razonamiento que hay detrás de una predicción antes de poder fiarse de ella.
Los modelos opacos también dificultan detectar cuándo una predicción responde a algo espurio, como un patrón en los datos que no refleja una biología real. En un entorno clínico, ese tipo de error oculto tiene consecuencias reales.
Por eso, desde el primer día nos marcamos un objetivo distinto: un modelo que sea preciso y que se explique a sí mismo.
Nuestro enfoque: lógica que se puede leer, causas que se pueden cuestionar
En lugar de otro modelo profundo de caja negra, combinamos dos ideas: las Máquinas de Tsetlin y la inferencia causal.
Las Máquinas de Tsetlin son una familia de modelos de aprendizaje automático introducida por Ole-Christoffer Granmo en 2018. En lugar de ajustar millones de pesos numéricos, aprenden patrones en forma de cláusulas lógicas sencillas, del tipo «si esto Y esto Y NO aquello». Muchas de estas cláusulas votan conjuntamente para llegar a una predicción. Como el conocimiento aprendido está escrito en lógica llana, una persona puede leerlo directamente.
La inferencia causal es un conjunto de métodos para distinguir lo que realmente determina un resultado de lo que simplemente aparece junto a él. En sanidad, la diferencia importa: un factor que solo está correlacionado con un tipo de ictus es una base débil para una decisión clínica, mientras que uno con un papel causal es algo sobre lo que un neurólogo puede razonar.
Combinar ambas nos da un modelo con un propósito claro. Aprende reglas compactas y legibles por humanos a partir de los datos, y lo hace atendiendo a lo que realmente hay detrás de una predicción y no a las coincidencias. El resultado es un modelo que predice el tipo de ictus con un 88 % de precisión sin ocultar cómo ha llegado a esa conclusión.
Lo que ve el clínico
Para cada paciente, PREVICTS ofrece dos cosas:
Una probabilidad sencilla (%) para cada tipo de ictus, de modo que el clínico ve de un vistazo cómo pondera el modelo las distintas posibilidades.
Una explicación legible en cláusulas lógicas de lo que determina la predicción, escrita como lógica y no como una puntuación procedente de una capa oculta.
No hay pesos opacos que aceptar por fe. Un neurólogo puede leer las cláusulas, compararlas con su propio criterio clínico y cuestionar cualquier cosa que no le encaje. Si el razonamiento se sostiene, la predicción se convierte en una segunda opinión fiable. Si no, el clínico puede ver exactamente dónde falla.
Este es el principio que guía el proyecto: la IA debe apoyar las decisiones clínicas, no sustituir al profesional que las toma.
Entrenado on-prem, diseñado para desplegarse
Los datos de salud están entre la información más sensible que existe y están sujetos a estrictos estándares médicos y de seguridad. Un modelo que no pueda respetarlos nunca saldrá del laboratorio.
Por eso, todo el entrenamiento del modelo central de PREVICTS se realizó on-prem en el hospital, bajo sus propios estándares médicos y de seguridad. Los datos de los pacientes nunca salieron del edificio.
No fue un atajo. Es precisamente lo que hace que el modelo sea desplegable: se construyó desde el principio dentro del entorno donde debe funcionar, junto a las personas responsables de proteger esos datos. Trabajar así también significa que los resultados proceden del entorno clínico real, y no de una versión simplificada del mismo.
Una colaboración en conjunto
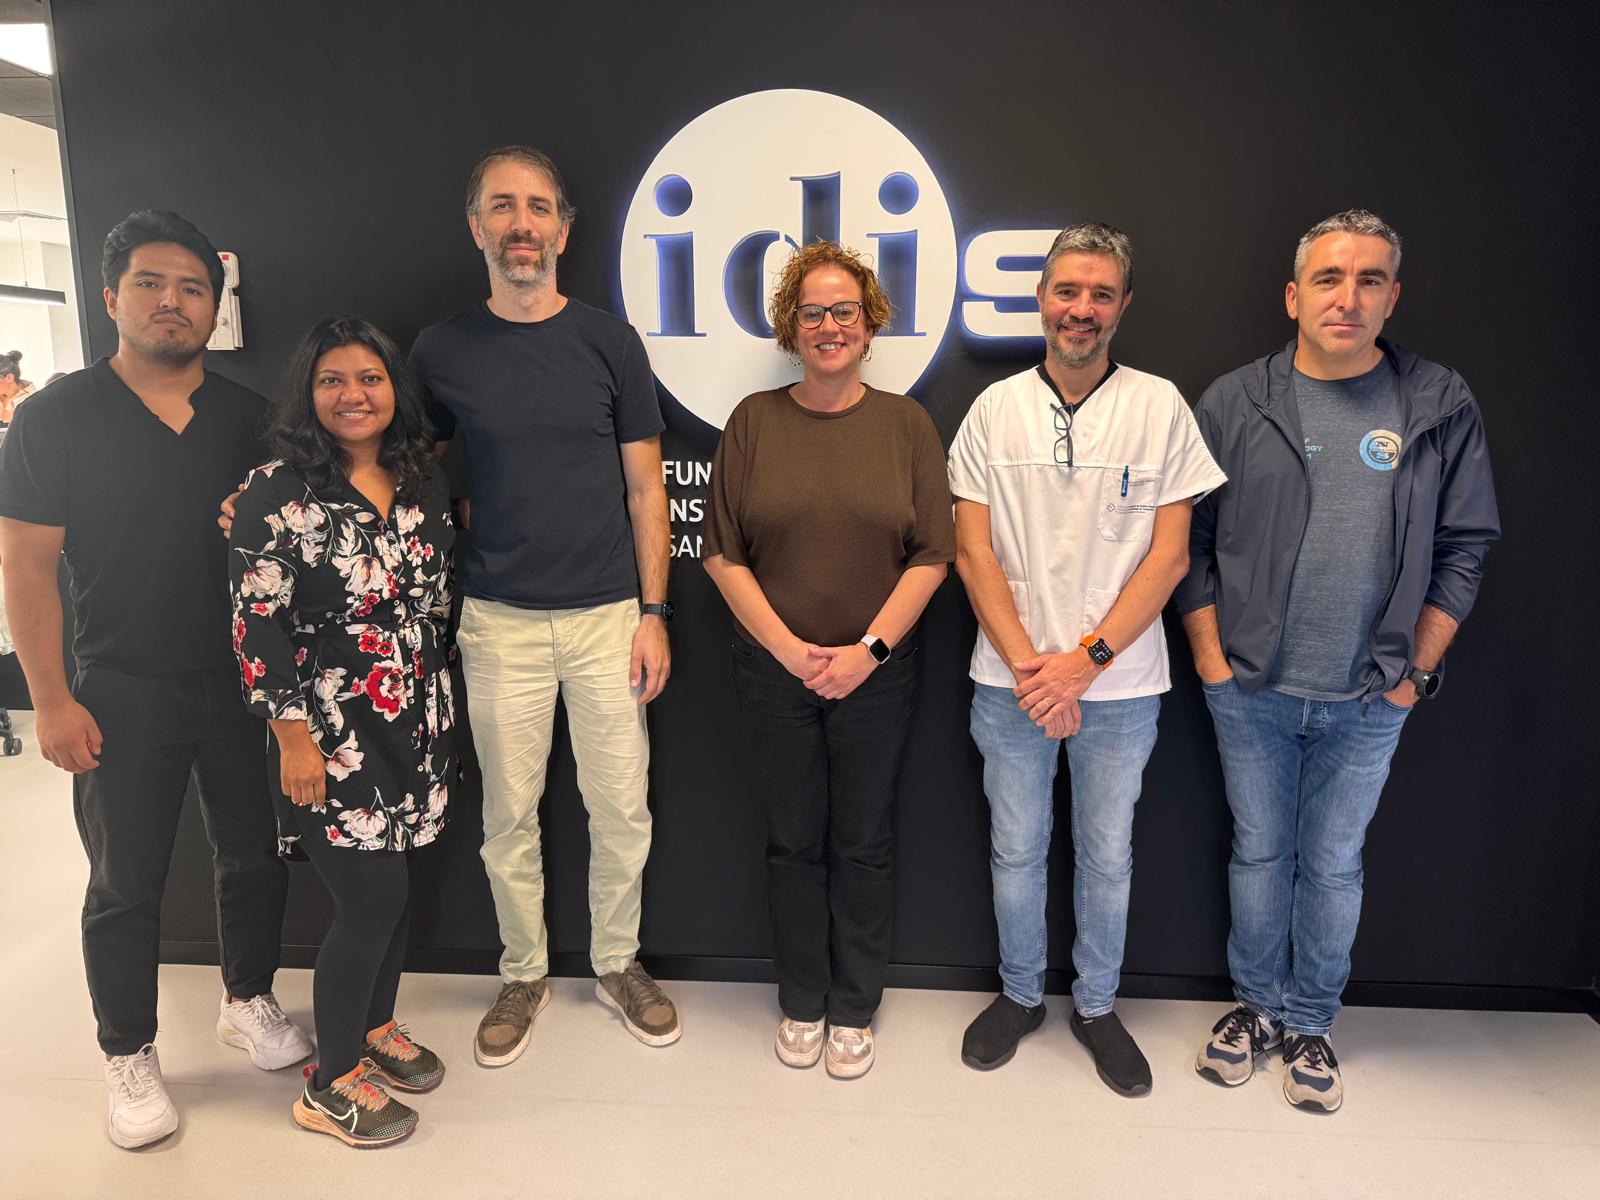
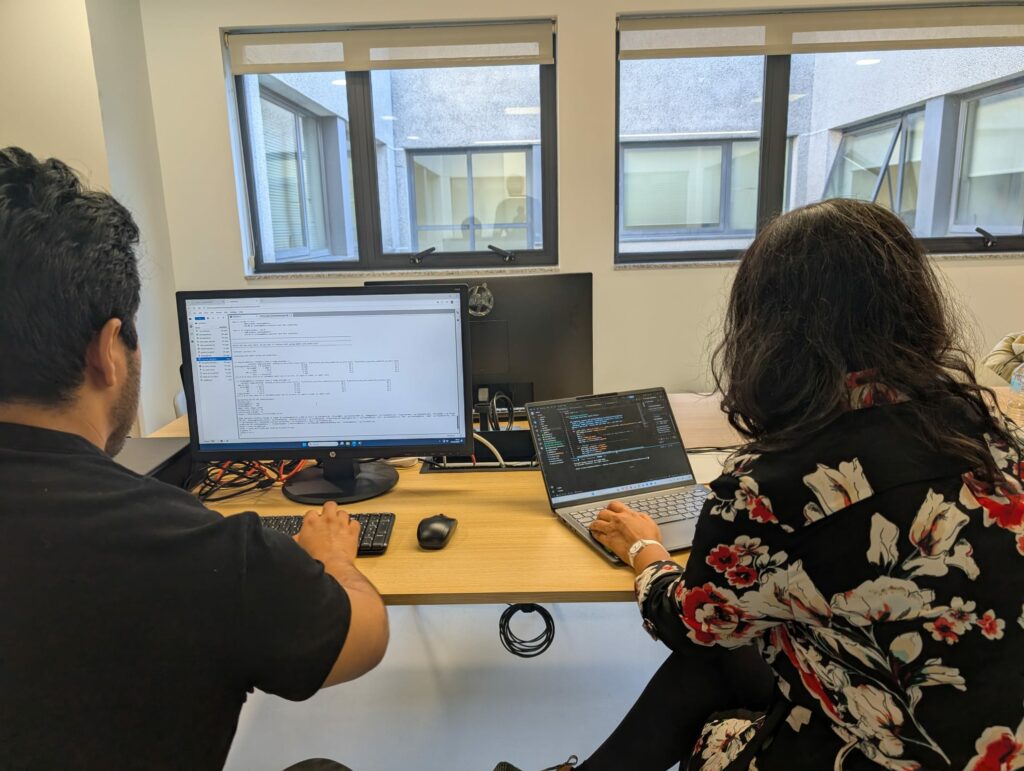
PREVICTS no es algo que se haya construido en remoto y entregado al final. Nuestro equipo viajó a Santiago de Compostela y trabajó allí con los investigadores de IDIS para entrenar el modelo central, en el lugar donde están los datos y donde surgen las preguntas clínicas.
Esto no existiría sin Jalpa Soni, PhD (lead data scientist), Bryan Kevin Condor Romero (full-stack mage) y Victor Saenger (R&D Tech Lead).
Nuestro enorme agradecimiento también a Francisco Campos, Manuel y Mabel, a todo el equipo del Instituto de Investigación Sanitaria de Santiago de Compostela y a nuestros compañeros del laboratorio de investigación de Capitole Lab.
Lo que viene ahora
Entrenar el modelo central es un hito importante, pero es solo el comienzo del camino. Nuestra colaboración continua con IDIS seguirá mejorando la plataforma, y estamos ilusionados con lo que viene.
PREVICTS es un proyecto financiado por el CDTI (Centro para el Desarrollo Tecnológico y la Innovación), desarrollado entre Capitole Lab e IDIS. Muestra lo que es posible cuando los equipos tecnológicos y los investigadores clínicos trabajan en la misma sala: una IA precisa, comprensible y preparada para la realidad de un hospital.
Una vez más, gracias al Instituto de Investigación Sanitaria de Santiago de Compostela por hacer posible esta colaboración.