Una guía práctica de tres técnicas de prompting que convierten peticiones vagas en resultados útiles
Si tuviera que resumir en una sola frase lo que he aprendido trabajando con IA generativa, sería esta: mejor input, mejor output. La calidad de lo que obtienes de una herramienta de IA depende de lo que le das.
Lo veo una y otra vez en el trabajo de adopción de IA que hago con equipos. Un prompt vago produce una respuesta genérica. Una respuesta genérica lleva a otro prompt, y luego a otro, hasta que el resultado por fin sirve, o hasta que nos rendimos y hacemos la tarea nosotros mismos. Cada una de esas vueltas tiene un coste:
- Tiempo. Cada iteración supone escribir, esperar, leer y corregir. Un prompt bien construido te lleva al resultado en una o dos vueltas en lugar de seis.
- Calidad y confianza. Cada vuelta extra es otra oportunidad para que el resultado se desvíe. Cuando el output no da en el clavo una y otra vez, la gente deja de confiar en él y deja de usar la herramienta para el trabajo que más importa.
- Frustración. En mi experiencia, la mayoría de los momentos de «la IA no funciona» no son fallos del modelo. Son problemas de input. Arregla el input y la frustración desaparece con él.
Si trabajas con la API. Quienes desarrollan y llaman a los modelos a través de una API pagan por token, la unidad básica que un modelo lee y escribe (más o menos una palabra o un fragmento de ella), así que cada vuelta desperdiciada también se factura. Con una licencia de Copilot, ChatGPT o Claude no pagas por token, pero los planes tienen límites de uso, y las conversaciones largas y repetitivas los alcanzan antes.
En este artículo comparto las tres técnicas que más recomiendo para mejorar la calidad de tu input: metaprompting, role prompting y chain-of-thought. Para cada una explico qué es, cuándo la uso y cuáles son sus límites.
Cómo es un buen input
Todo prompt eficaz responde a cuatro preguntas. Si falta una, el modelo rellena el hueco con suposiciones.
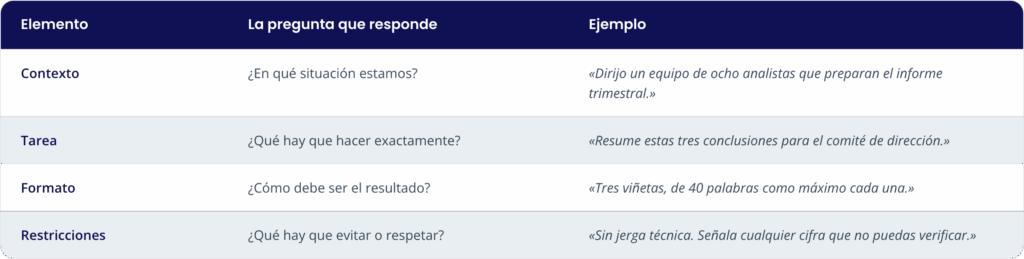
La palanca más barata de todas: muestra un ejemplo. Además de estos cuatro elementos, la forma más rápida de conseguir el resultado que quieres suele ser enseñarlo. Pega un resumen que te gustó, un correo modelo o dos filas de ejemplo de la tabla que esperas, y añade «sigue este formato y este tono». Un buen ejemplo elimina más ambigüedad que un párrafo de descripción.
Las tres técnicas que vienen a continuación se apoyan en esta base. No la sustituyen.
1. Metaprompting: deja que la IA construya el prompt contigo
El metaprompting consiste en usar la IA para redactar, evaluar o mejorar tus propios prompts. En lugar de pedir el resultado, pides una forma mejor de pedirlo.
Úsalo en tres situaciones:
- La tarea es crítica y el resultado tiene que ser correcto.
- Tu prompt sigue dando resultados flojos y no ves por qué.
- Estás escribiendo un prompt que otras personas o equipos van a reutilizar.
El proceso es sencillo:
- Tu prompt: el primer intento, normalmente demasiado vago.
- El metaprompt: pides a la IA que lo evalúe y lo mejore.
- El prompt mejorado: preciso, estructurado y reutilizable.
- Un output mejor: un resultado que de verdad puedes usar.
Hay cuatro formas de aplicarlo, según el punto en el que estés:
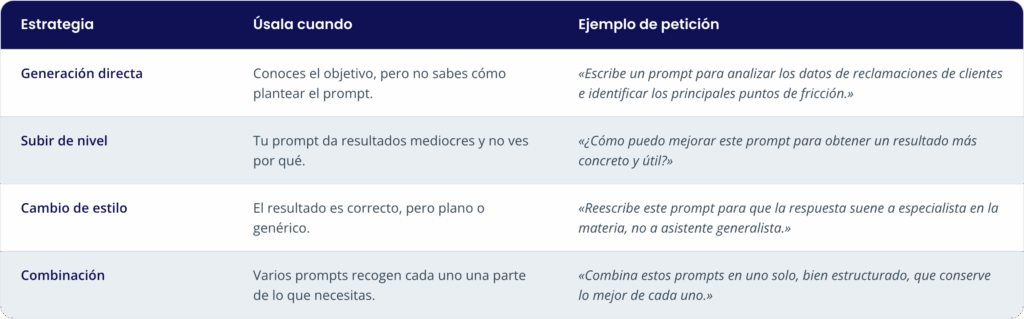
Hay una regla que siempre comparto cuando formo a equipos y que hace que las cuatro funcionen mejor: dile a la IA qué falla en el resultado actual y para qué lo necesitas. Cuanto más preciso sea el diagnóstico, mejor será la solución.
El metaprompting no es solo un hábito de usuario. Los proveedores de IA lo han integrado en sus herramientas para desarrolladores: el Playground de OpenAI, por ejemplo, tiene una opción Generate que escribe o mejora un prompt a partir de la descripción de la tarea, y la Console de Anthropic ofrece un generador de prompts y un mejorador de prompts. Estas herramientas están pensadas para quienes desarrollan con la API. Si trabajas en Copilot, ChatGPT, Claude o Gemini, no las necesitas: basta con pedirle al chat que mejore tu prompt, como se describe arriba. Y es revelador que el mejorador de prompts de Anthropic te invite a añadir comentarios sobre qué funciona y qué no en tus resultados actuales: la misma regla que comparto con los equipos.
Una nota sobre terminología. En la investigación académica, metaprompting también designa una técnica más avanzada. En Suzgun y Kalai (2024), un único modelo actúa como «director» que divide una tarea compleja en subtareas, las asigna a instancias «expertas» de sí mismo y después integra y verifica los resultados. Este artículo usa el término en su sentido práctico y de negocio: pedir a la IA que te ayude a construir mejores prompts.
2. Role prompting: prepara el escenario una sola vez
El role prompting configura la IA para que responda como un tipo concreto de experto, con un contexto, unas reglas y un propósito definidos. Preparas el escenario una vez al inicio de la conversación y todas las respuestas siguen esa configuración. No hace falta repetir el contexto en cada mensaje.
Funciona mejor para todo lo relacionado con cómo se dice algo: el tono, el vocabulario, el punto de vista y la dinámica de una conversación. Por eso es la herramienta adecuada para ensayos, simulaciones, feedback y juegos de rol.
Un buen role prompt tiene cuatro componentes:
- Asigna un rol: «Actúa como un Scrum Master sénior con 10 años de experiencia liderando equipos ágiles en servicios financieros.»
- Plantea el escenario: «Soy un project manager júnior a punto de dirigir mi primera retrospectiva de sprint. Quiero practicar cómo gestionar un conflicto entre dos miembros del equipo sobre quién es responsable de un entregable.»
- Define las reglas: «Pregúntame cómo gestionaría cada situación antes de darme feedback. No me des la respuesta. Guíame con preguntas.»
- Fija una frase de cierre y un resultado final: «Cuando escriba “retrospectiva terminada”, da por acabada la simulación y resume lo que hice bien y un aspecto concreto que debo mejorar.»
Esto es lo que más sorprende cuando lo explico: de los cuatro componentes, el rol es el que menos peso tiene por sí solo. El escenario, las reglas y el resultado final son lo que convierte un chat genérico en un ejercicio útil.
Lo que el role prompting no es
- No hace que la IA sea más precisa. Decirle a un modelo que «actúe como abogado» no lo convierte en una fuente jurídica más fiable. Un estudio con 162 perfiles presentado en EMNLP 2024 (Zheng et al.) concluyó que añadir perfiles no mejoraba el rendimiento en preguntas factuales. Los Wharton Generative AI Labs llegaron a la misma conclusión en diciembre de 2025 y recomiendan centrarse en instrucciones específicas de la tarea.
- No le da a la IA experiencia real. Un rol no añade conocimiento, empatía ni contexto sobre tu organización que el modelo no tenga ya. El feedback que da es un punto de partida, no un veredicto.
- No es persistente, salvo que lo guardes. En un chat, el rol vive en esa conversación y termina con ella. Cuando un role prompt funciona, el siguiente paso natural es guardarlo como instrucciones permanentes: un Proyecto en Claude, un GPT personalizado o un Proyecto en ChatGPT, una Gem en Gemini, o un agente creado con Agent Builder en Microsoft 365 Copilot. Guardado así, se convierte en un recurso reutilizable para todo el equipo, con el mismo contexto, las mismas reglas y el mismo resultado final cada vez.
- No es un agente de IA. Un agente puede planificar, conectarse a herramientas externas y ejecutar flujos de trabajo de varios pasos con cierto grado de autonomía. El role prompting es una técnica de conversación: la IA no realiza ninguna acción fuera del chat.
Protección de datos. Un ensayo no necesita datos reales. Describe las situaciones en términos genéricos, sin nombres ni información personal o de desempeño que permita identificar a nadie, y usa solo las herramientas que tu organización haya aprobado.
3. Chain-of-thought: haz visible el razonamiento
El prompting chain-of-thought (CoT), o cadena de razonamiento, pide al modelo que resuelva un problema mediante pasos intermedios antes de dar su respuesta final. Investigadores de Google demostraron en 2022 (Wei et al., NeurIPS 2022) que incluir ejemplos resueltos con razonamiento paso a paso mejora el rendimiento en tareas aritméticas, de sentido común y de razonamiento simbólico. Meses después, Kojima et al. (2022) comprobaron que añadir simplemente «Pensemos paso a paso», sin ningún ejemplo, también ayudaba.
El principio es sencillo: un problema de varios pasos resuelto paso a paso produce menos errores que uno resuelto de un salto. Y cuando el razonamiento queda por escrito, puedes comprobarlo.
Hay dos formas de aplicarlo:
- CoT simple: añade una instrucción como «Razona esto paso a paso antes de responder.»
- CoT guiado: detalla los pasos que quieres que siga el modelo: el orden, los criterios y qué decide el resultado. En la práctica, esto es descomponer la tarea, y es más fiable porque eres tú quien define la lógica.
Ejemplo de un prompt de CoT guiado:
«Tenemos que decidir cuál de estos tres proveedores pasa a la lista corta. Hazlo en este orden: 1) enumera los requisitos que cumple y no cumple cada proveedor; 2) compara el coste total a tres años; 3) identifica el principal riesgo de cada opción; 4) solo entonces da una recomendación, explicando qué paso ha sido decisivo.»
Recurro al chain-of-thought guiado para comparaciones, decisiones con varios criterios, cálculos, planificación y cualquier análisis en el que necesito ver cómo se ha llegado a la conclusión. Lo evito en peticiones sencillas, como un resumen, una traducción o un correo breve.
La versión genérica pierde fuerza; la guiada se queda. Los Wharton Generative AI Labs (junio de 2025) observaron que muchos modelos recientes ya razonan paso a paso sin que se les pida, y que en los modelos de razonamiento una petición explícita de CoT apenas mejora la precisión y, en cambio, cuesta bastante tiempo. Con los modelos de razonamiento y los modos de «pensamiento» que ya incluyen la mayoría de las herramientas, un «piensa paso a paso» genérico es casi redundante. El CoT guiado es distinto: no le pide al modelo que piense, le dice cómo descomponer la tarea, en qué orden y con qué criterios. Lo que sigue aportando valor con cualquier modelo son tus criterios y lo que la respuesta tiene que demostrar; con los modelos de razonamiento, fija el orden solo cuando el resultado lo requiera. La conclusión: por defecto, prescinde de la instrucción genérica y sigue detallando los pasos en las decisiones complejas.
Qué técnica usar y cuándo
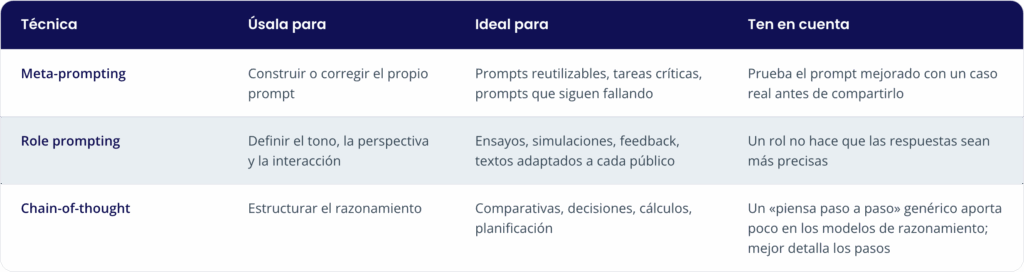
Las tres se combinan bien. Usa el metaprompting para redactar un role prompt, o dale a un rol una secuencia guiada de pasos que seguir. En todos los casos, el output solo es tan bueno como el input.
Por dónde empezar
- Elige un prompt que uses a menudo y cuyos resultados no te acaben de convencer.
- Pide a la IA que lo mejore. Explícale qué falla y para qué necesitas el resultado.
- Elige una conversación o una presentación que quieras ensayar y construye un role prompt con sus cuatro componentes. Si funciona, guárdalo como instrucciones en un Proyecto, un GPT, una Gem o un agente.
- Toma una decisión o un análisis con varios criterios y escribe un prompt de chain-of-thought guiado para ello.
- Comparte con tu equipo los prompts y las instrucciones guardadas que funcionen. Es la forma más rápida de escalar lo que aprendes.
Conclusión
Después de años trabajando donde se cruzan la gestión del cambio y la tecnología, tengo clara una cosa: para la mayoría de las personas, en su trabajo diario, las mayores mejoras con la IA generativa no vienen de cambiar de modelo. Vienen de cómo preguntamos.
El metaprompting convierte peticiones vagas en instrucciones precisas y reutilizables. El role prompting te da un espacio seguro para practicar y recibir feedback y, una vez guardado como instrucciones, un recurso reutilizable para tu equipo. El chain-of-thought guiado hace que el razonamiento complejo sea estructurado y verificable.
Las tres se basan en el mismo principio: mejor input, mejor output. Menos vueltas, menos tiempo perdido, resultados en los que puedes confiar y menos frustración. Y algo que recuerdo a todos los equipos con los que trabajo: la IA amplifica tu criterio, no lo sustituye. Validar los resultados y proteger la información sensible sigue siendo responsabilidad nuestra.
Si pruebas alguna de estas técnicas, me encantará saber cómo te ha ido.
Fuentes
- Wei, J. et al. (2022). Chain-of-Thought Prompting Elicits Reasoning in Large Language Models. NeurIPS 2022.
- Kojima, T. et al. (2022). Large Language Models are Zero-Shot Reasoners. NeurIPS 2022.
- Suzgun, M. y Kalai, A. T. (2024). Meta-Prompting: Enhancing Language Models with Task-Agnostic Scaffolding. arXiv.
- Zheng, M. et al. (2024). When “A Helpful Assistant” Is Not Really Helpful: Personas in System Prompts Do Not Improve Performances of Large Language Models. Findings of EMNLP 2024.
- Meincke, L. et al. (2025). The Decreasing Value of Chain of Thought in Prompting. Wharton Generative AI Labs.
- Basil, S. et al. (2025). Playing Pretend: Expert Personas Don’t Improve Factual Accuracy. Wharton Generative AI Labs.
- Anthropic. Herramientas de prompting de la Console y Prompt improver (herramientas para desarrolladores).
- OpenAI. Generación de prompts en el Playground (herramientas para desarrolladores).