Los humanos tratamos de humanizarlo todo: vestimos a las mascotas, le ponemos nombre al coche…, y cómo no, ahora le toca el turno a la IA. No me refiero a tratarla con mucha cordialidad (con la idea de que si llega la rebelión de las máquinas se apiade de nosotros), sino a que le requerimos que replique nuestros flujos de trabajo, tal cual los hacemos nosotros sin pararnos a pensar si es la manera correcta de realizarlo.
Como humanos, nos especializamos, nos cansamos, olvidamos información y necesitamos mecanismos que nos ayuden a organizarnos. De ahí surgen las pull requests, las revisiones de código, los roles, Scrum, los sprints o las dailies: herramientas y prácticas diseñadas para coordinar equipos y compensar nuestras propias limitaciones.
Sin embargo, cuando los agentes empezaron a escribir código, simplemente les dimos las mismas herramientas y procesos que habíamos diseñado para nosotros.
Los agentes también tienen limitaciones, solo que no son las nuestras: no se cansan ni necesitan un cargo, pero no recuerdan nada entre sesiones y producen más de lo que somos capaces de leer. El error es darles los remedios de nuestros defectos en lugar de los de los suyos.
Empecemos viendo qué ocurre al humanizar la IA en dos paradigmas habituales en equipos de desarrollo con una adopción avanzada:
El espejismo del organigrama: agentes que emulan roles humanos
Seguro que alguna vez habéis visto u oído hablar de los sistemas de desarrollo multiagentes, en herramientas como Claude Code u Open Code, donde es posible organizar varios subagentes para generar código. En algunas organizaciones se tiende a diseñar estos subagentes de forma que cada uno de ellos emula un rol, uno de frontend, otro de backend, un QA, UI-UX, un arquitecto, etc. A primera vista resulta intuitivo, ¿pero es la mejor forma de hacerlo?
Replicar esta estructura humana entre máquinas genera dos grandes problemas: un coste operativo muy elevado y un harness (el andamiaje técnico que orquesta a los agentes) que en ocasiones acaba siendo más complejo de mantener que el propio código.
Respecto al coste, Anthropic midió que sus sistemas multiagente consumen unas 15 veces más tokens que una conversación de chat. La propia compañía reconoce además que programar es menos paralelizable que investigar, por lo que el beneficio de repartir el trabajo entre varios agentes es menor justo en nuestro ámbito (Anthropic, 2025).
Respecto a la complejidad, no se reduce al «código del arnés»: se traduce en más fallos. El estudio MAST (Universidad de California en Berkeley) analizó sistemas como ChatDev y MetaGPT, que simulan una empresa de software con cargos (CEO, CPO, programador, tester…). En él, las tasas de error van del 41 % al 86,7 % según el sistema y el modelo evaluados, y no son comparables entre sí. En uno de los fallos observados, el agente «CPO» llega a cerrar la conversación sin contar con el «CEO» (Cemri et al., 2025, NeurIPS).
Por ello, nos debemos preguntar: ¿mi equipo necesita un sistema de agentes? ¿Qué quiero conseguir con ello? Existen razones genuinas para ello, los sistemas multiagentes pueden ser muy eficaces para mejorar el output del código generado o pueden ayudar en situaciones donde sea interesante hacer una gestión de la ventana de contexto más elaborada.
Así pues, una vez detectada la necesidad, ¿cuál es la alternativa? ¿Cómo lo hago para trabajar con un sistema multiagentes de manera eficaz?
Para ello, existen dos vías de acción:
- La opción más simple, el Evaluator-Optimizer, donde un agente ejecuta y otro agente lo juzga y evalúa. Este patrón últimamente está ganando popularidad, por su simplicidad (y bajo precio). Un ejemplo es el Gauntlet Loop de Matt Shumer (https://www.tenex.co/playbooks/gauntlet-loop): un agente constructor y un subagente crítico trabajan en bucle dentro de un harness agéntico, y nació precisamente haciendo software.
- Dejar de dividir por cargos y descomponer el trabajo por tarea, contexto y herramientas. Es importante hacer este mapeo para no tener la tentación de crear agentes de más. Un ejemplo de descomposición por contexto sería: un agente que implementa el cambio, un subagente que explora el repositorio y le devuelve solo lo relevante (así el agente principal no carga con todo el código en su ventana de contexto), y un evaluador que ejecuta los tests contra la spec. Cada uno existe por lo que necesita ver y hacer, no por un cargo. Y si con eso basta, lo correcto es un solo agente con buenas herramientas. Una manera de proceder después de este análisis es seguir la línea de lo que propone Anthropic en su «Building effective agents» (https://www.anthropic.com/engineering/building-effective-agents): construye estos agentes solo cuando hay un motivo específico y utiliza en primer lugar los patrones más sencillos antes de escalar al más complejo de todos.
Scrum con agentes: cuando el cuello de botella cambia de sitio
Según el informe de McKinsey, el 20 % de los desarrolladores con mejores resultados declara una mejora media de productividad del 55 % (https://www.mckinsey.com/industries/technology-media-and-telecommunications/our-insights/beyond-the-copilot-scaling-the-agentic-product-development-life-cycle), frente a solo un 3 % en el 80 % restante. Conviene pararnos ante esto y analizarlo con cautela: es un dato autodeclarado. Un dato medido apunta en la misma dirección: según Sonar, el ciclo de PR es 3,4 veces más corto (Case study: AI in the product development life cycle | McKinsey). Sin embargo, McKinsey señala que lo que separa a ese 20 % no es el uso de IA, sino que el modelo operativo resultante se parece poco a Scrum. Por ejemplo, cita un banco que trabaja con sprints diarios. Además, define a los agentes por su mandato y sus permisos, no por un organigrama.
Por ello, la clave de ese cambio es replantear el Scrum en los equipos con mejores resultados a la hora de implantar la IA. La réplica habitual en gestión es: «Scrum es solo un framework, adáptalo». Pero cuando se alcanzan estas cotas de productividad, el problema no es el nombre del framework, sino:
- La cadencia: Un sprint de dos o tres semanas está calibrado para la velocidad humana y para el horizonte en el que podemos ser “relativamente precisos” con nuestras estimaciones. Sin embargo, en equipos de agentes autónomos o semiautónomos donde avanza ferozmente un backlog, esta cadencia puede dejar de tener sentido.
- Cuello de botella: Lo que limita ahora a un equipo no es el tiempo de picar código, sino su capacidad para definir y verificar a la velocidad producida por la máquina.
- Contexto: Una Pull Request (PR) asume que el autor estará ahí, que recordará el motivo de la toma de decisión y que responderá por su desarrollo, en cambio, un agente se limitará al cierre de su sesión y su contexto desaparecerá.
En este punto es preciso detenerse, dado que para un mánager es fácil caer en la tentación de pensar que llegar a un nivel tan elevado de productividad parece más una bendición que un problema. Más PRs no significa siempre más valor entregado. Si se mantiene el mismo proceso, la capacidad de lectura humana se mantiene plana y los tiempos de espera en revisión empiezan a contarse por semanas. El cuello de botella simplemente se ha movido a la revisión y la alineación.
Pero ¿son estos cuellos de botella algo exclusivo de pequeñas startups trabajando en proyectos greenfield con un enfoque AI-first muy agresivo? La respuesta es no: gigantes como Salesforce han tenido que rediseñar su flujo por completo. En su blog de ingeniería (https://engineering.salesforce.com/scaling-code-reviews-adapting-to-a-surge-in-ai-generated-code/) explican cómo la avalancha de código generado por IA disparó los tiempos de ciclo de sus PRs y colapsó la capacidad de sus ingenieros senior. ¿Su solución? No fue dejar a los humanos «solo lo crítico», sino rehacer el proceso de revisión: al abrirse una PR, una herramienta analiza la intención del cambio, añade contexto y marca el riesgo, y la aprobación sigue siendo humana. Y aquí hay una lección para nosotros: Salesforce reconstruye la intención después de escribir el código; con una spec, esa intención se fija antes.
Incluso antes de los agentes, hay equipos que han abandonado el sprint porque no encaja con un trabajo que cambia de forma continua; con agentes produciendo a todas horas, ese desajuste solo crece. Es el caso de Oleksandr Kondratiuk, que explicaba en CIO (https://www.cio.com/article/4180863/how-a-20-engineer-team-delivers-enterprise-ai-systems-at-fortune-500-scale.html) cómo su equipo entrega plataformas de IA para clientes Fortune 500 tras abandonar Scrum por completo. El motivo no fue desarrollar con IA, sino que su producto cambia sin parar (pipelines, reentrenos), y los copilotos llegaron después. Su solución fue cambiar el ritual del sprint por entrega continua (Kanban) basada en validaciones automatizadas.
No te conformes: mide lo que dicen los datos
Cuestionar las metodologías no significa adquirir cualquier promesa de aceleración a ciegas. Si introducimos procesos de IA sobre el mismo equipo, tenemos que analizar cuidadosamente qué efecto está teniendo sobre él. Por ello, se debe ir con atención de no medir el éxito, por ejemplo, solo con encuestas de satisfacción, porque si se depende solo de este punto, se cae de lleno en la paradoja de la productividad de la IA (los desarrolladores aseguran sentirse mucho más rápidos, pero las métricas del sistema muestran otra realidad: o no hay aceleración real, o se entrega más rápido, pero con más errores).
¿Por qué ocurre esta desconexión entre percepción y realidad? Por un principio básico de gestión de flujos: optimizar una tarea local (escribir código) sin tocar el cuello de botella del sistema (revisar, alinear y validar) solo genera una ilusión de velocidad.
Lo que nos dicen algunos datos empíricos sobre el impacto de la IA:
| Estudio | El dato | Lectura |
| METR (Model Evaluation and Threat Research) 2025 https://metr.org/blog/2025-07-10-early-2025-ai-experienced-os-dev-study/ | Percepción: Los desarrolladores creían ser más rápidos con IA (percibían un 20% de mejora). Realidad: La medición no lo confirmaba (tardaron un 19% más), siendo relevante la brecha entre lo que se percibe y lo que se mide. | Eliminar la fricción de la página en blanco da sensación de velocidad, pero no reduce el Lead Time. No midas con encuestas de satisfacción. |
| DORA (DevOps Research and Assessment) 2025 https://cloud.google.com/resources/content/2025-dora-ai-assisted-software-development-report | Percepción: Más del 80% declara mayor productividad individual (con un 90% de adopción). Realidad: Un 30% no confía en el código generado, y aunque el throughput aumenta, la inestabilidad de entrega sube. Para medirlo, DORA ha introducido una nueva métrica oficial: la Tasa de Retrabajo. | Picar código más rápido sin cambiar el mecanismo de verificación solo incrementa el trabajo en curso (WIP), trasladando el riesgo a producción. |
Ceremonia frente a mecanismo
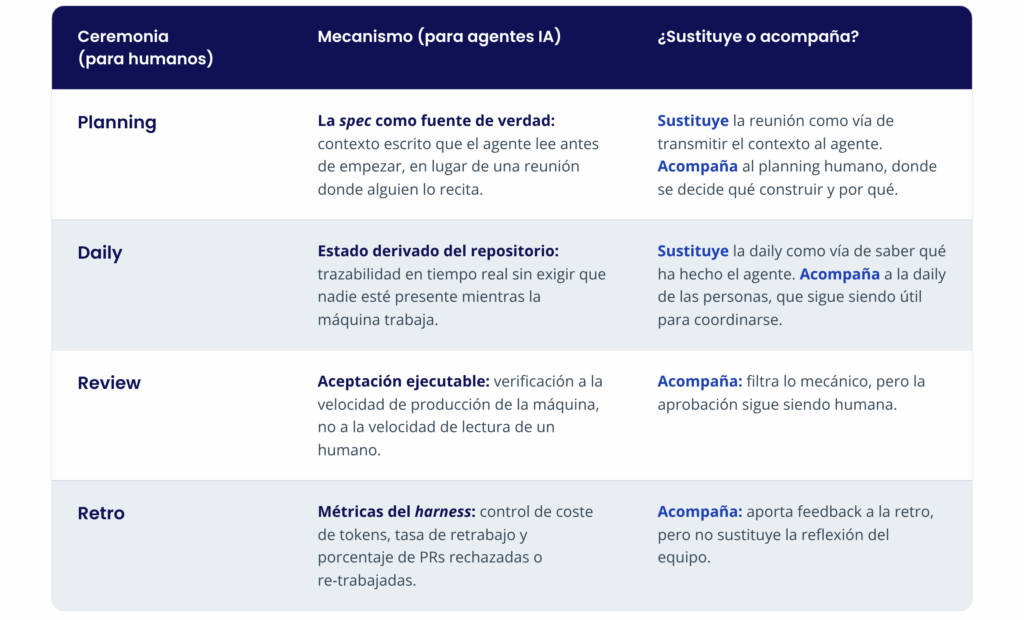
La ceremonia sirve al humano, que necesita pararse a pensar antes de ejecutar y sincronizarse con otros. El mecanismo sirve a la máquina. La IA no necesita tu planning; necesita buenas especificaciones para trabajar.
Así pues, si queremos gestionar equipos apoyados en agentes de manera eficaz, tenemos que dar a los humanos lo que necesitan los humanos y a los agentes de IA lo que necesitan los agentes de IA:
Cómo ir hacia un AI-First sin morir en el intento
Evolucionar nuestro ciclo de vida de desarrollo de software (SDLC) a uno AI-First, hoy en día, pasa por el SDD (Spec-Driven Development). Existen otras alternativas menos afianzadas como el Loop Engineering (bucles agénticos), pero el paso más certero para un SDLC tradicional es el SDD. Y aquí conviene precisar exactamente cómo conjuga lo hablado anteriormente con el uso del SDD.
El SDD, por sí solo, no resuelve el problema. De hecho, existen dos preguntas que nos deberíamos cuestionar:
¿Estamos implementando bien el SDD?
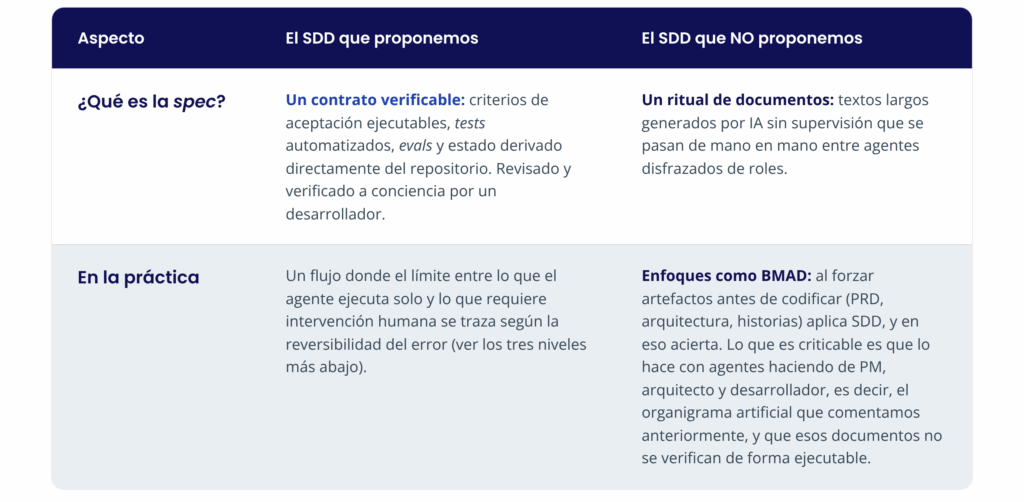
El límite lo marca la reversibilidad del error. McKinsey describe este mismo triaje por riesgo, y se traduce en tres niveles:
– Reversible y acotado (un refactor con tests, textos): el agente cierra solo si pasa la aceptación ejecutable.
– Reversible con impacto (una funcionalidad tras un feature flag): una persona valida la spec antes y los checks validan el código.
– Irreversible o regulado (migraciones de datos, permisos, cálculos normativos): revisión humana de diseño y de código, con aprobación nominal y evidencia.
Cuanto más difícil es deshacer un error, más pronto y más humano es el control.
¿Significa esto eliminar el control?
Todo lo contrario, especialmente en sectores regulados (banca, seguros, salud): si lideras el delivery en estos entornos, no puedes simplemente «apagar» la supervisión. Necesitas trazabilidad y control estrictos. Precisamente ahí, un arnés robusto, un contrato verificable con evals deterministas, superficies de acceso declaradas de antemano y validadas en servidor, y una clasificación explícita del riesgo (los tres niveles anteriores) ofrece una auditoría mucho más sólida que confiar en que un desarrollador cansado detecte un fallo leyendo su décima PR del día.
Es preciso destacar que este enfoque no se aplica de forma idéntica a todos los equipos, dado que no todos tienen el mismo nivel de madurez en la adopción de la IA, ni todas las soluciones son iguales. Un proyecto legacy de 15 años no es lo mismo que una prueba de concepto que el equipo empezó hace unos días. Antes de replantearnos sprints, ceremonias, roles y formas de trabajo, es importante entender el contexto que hace posible una transformación de este calado.
Conclusión: analiza qué le estás entregando a tu equipo
Durante años, hemos creado herramientas y procesos para compensar nuestros defectos. Así que, antes de entregarle a la IA tus herramientas y procesos, pregúntate si la máquina tiene los mismos defectos o si le estás aplicando remedios humanos (cargos, reuniones, revisiones manuales interminables) a limitaciones que son propias de un agente (amnesia entre sesiones y sobreproducción sin contexto).
Y si ya estás llevando a tu equipo hacia un enfoque AI-first y el volumen de delivery empieza a daros problemas, es el momento de cuestionarte: ¿estás diseñando mecanismos para los defectos reales de la máquina, o solo le estás enseñando a fingir que es uno más de vosotros?
No te quedes en el: “Si funciona no lo toques”, analiza cuál es la madurez de IA de tu equipo de desarrollo y no te conformes con lo presente: mide dónde está tu verdadero cuello de botella, busca siempre la mejora y experimenta, aunque eso implique romper con lo que estamos acostumbrados a hacer.